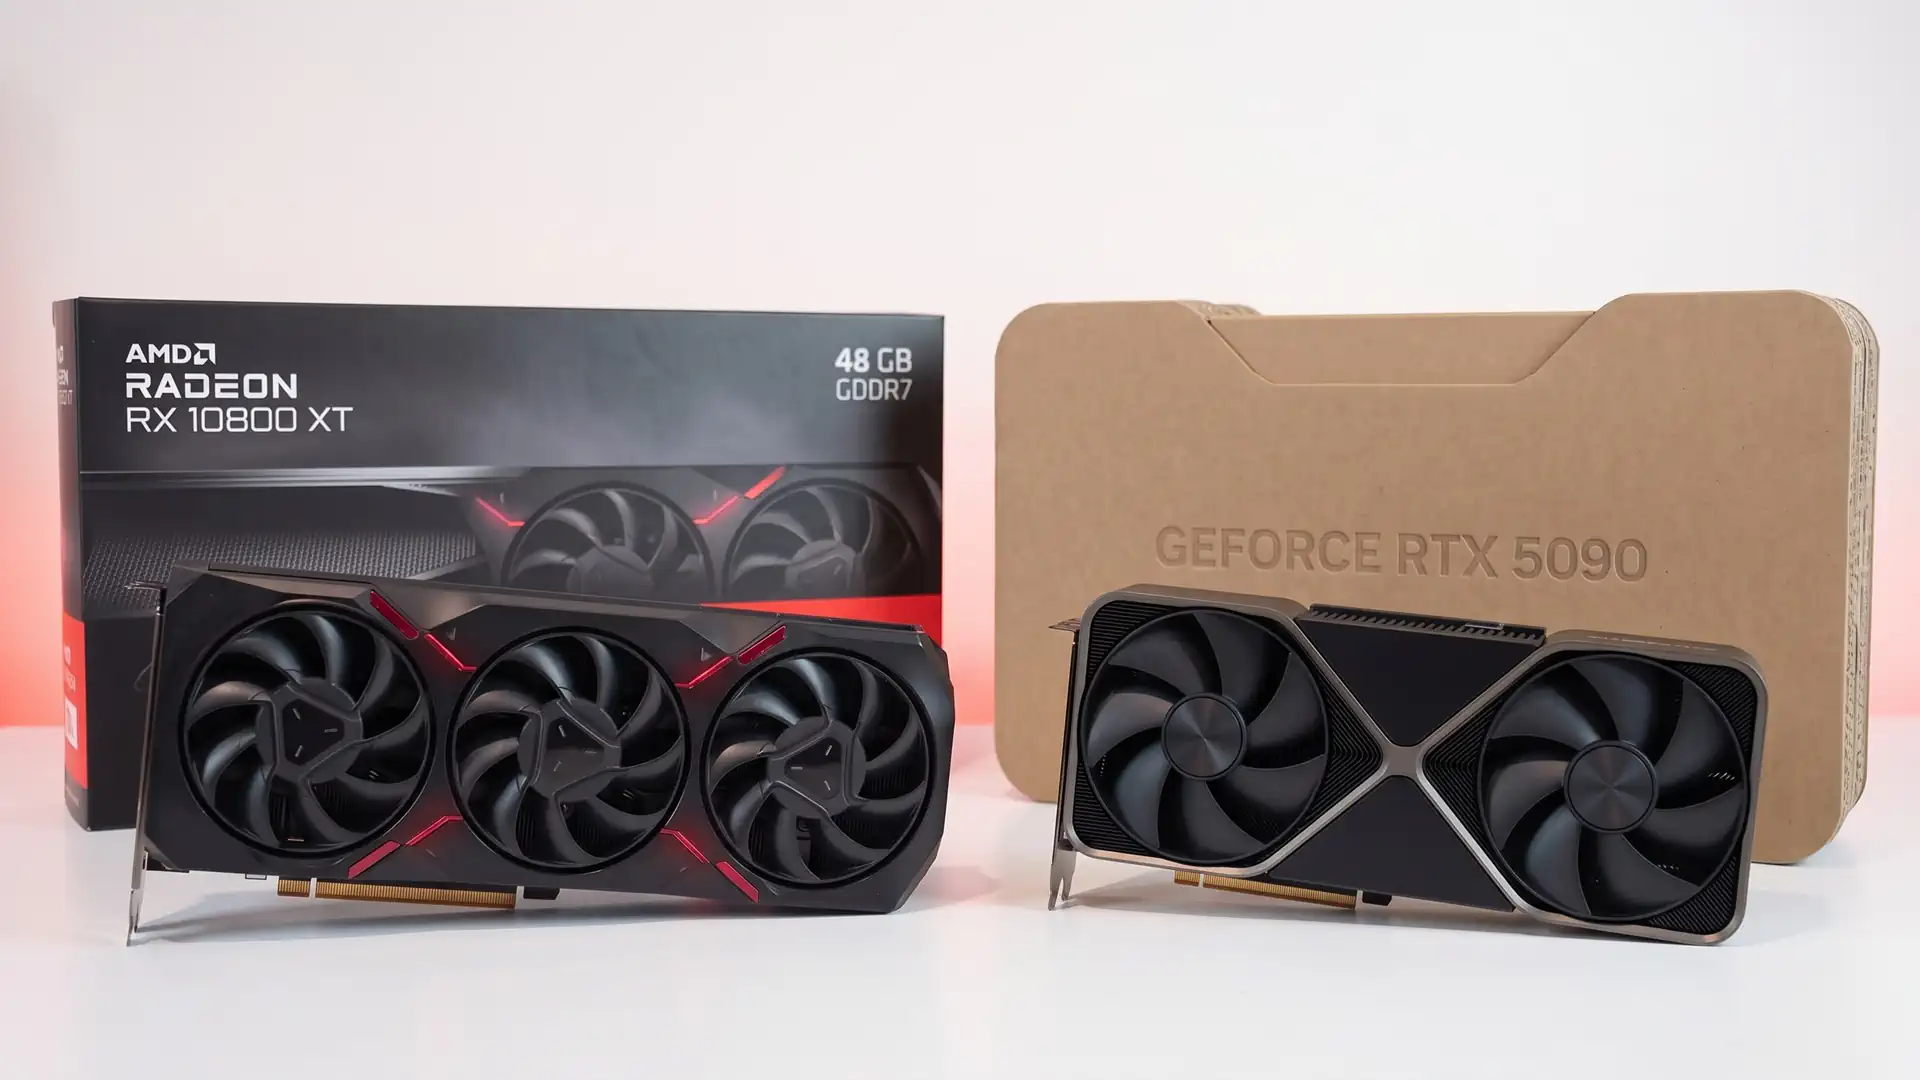
基于 RDNA 5 微架构的潜在旗舰 AMD Radeon RX 10800 XT 看起来已经像是该公司图形部门整个历史上最雄心勃勃的项目。 内部泄密(从摩尔定律失效到 Kepler_L2)归因于该芯片的巨大规格:多达 200 个计算单元 (CU)、庞大的 512 位总线、高达 48 GB 的快速 GDDR7 内存以及 3.1-3.4 GHz 新技术范围内的工作频率。
我们对即将推出的 AMD Radeon RX 10800 XT RDNA 5 架构旗舰显卡的计算单元规模的评估显示,与基础芯片 NVIDIA GeForce RTX 5090 Blackwell 和 RTX 6090 Rubin 相比,定量方法存在显着差异。全面的比较不仅需要考虑单元的数量,还需要考虑着色器处理器的内部密度以及特殊协处理器的存在。
旗舰级 NVIDIA GeForce RTX 5090 显卡配备 GB202 GPU,物理模式下有 192 个活动流多处理器 (SM),其中有 170 个。采用每个 SM 128 个 CUDA 核心的标准架构,总共提供 21,760 个 FP32 计算核心,并辅以 170 个硬件 RT 核心和 680 个 Tensor 核心。 NVIDIA 旗舰产品 GeForce RTX 6090 的下一代版本基于 Rubin 架构,拥有 192 个活动 SM,相当于 24,576 个 CUDA 核心,位居榜首。
AMD方面,则是基于RDNA 5 RTX 2090、面向200个计算单元的Radeon RX 10800 XT旗舰芯片。每个单元有 64 个典型的流处理器,总共有 12,800 个 ALU。尽管与 RTX 5090 21,760 相比,主着色器核心的物理数量较少,但 AMD 的小芯片架构允许 3.1-3.4 GHz 的极高工作频率,并放置巨大的无限缓存,补偿原始 FP32 计算的差异。
在没有光线追踪的传统光栅显示器中,200 个以超高频率运行的 CU 为 RX 10800 XT 带来了明显的优势。高达 48 GB 的 512 位 GDDR7 显存总线的高充电速度和带宽使新款 AMD 卡的性能比 4K 分辨率的 NVIDIA GeForce RTX 5090 高出 15-25%。然而,与即将推出的 RTX 6090 相比,光栅性能优势被抵消,Rubin 芯片的性能将优于拥有 192 个 CU 的 RTX 6090。 Radeon RX 10800 XT 15-20%,尽管AMD在能效方面保持着巨大优势。
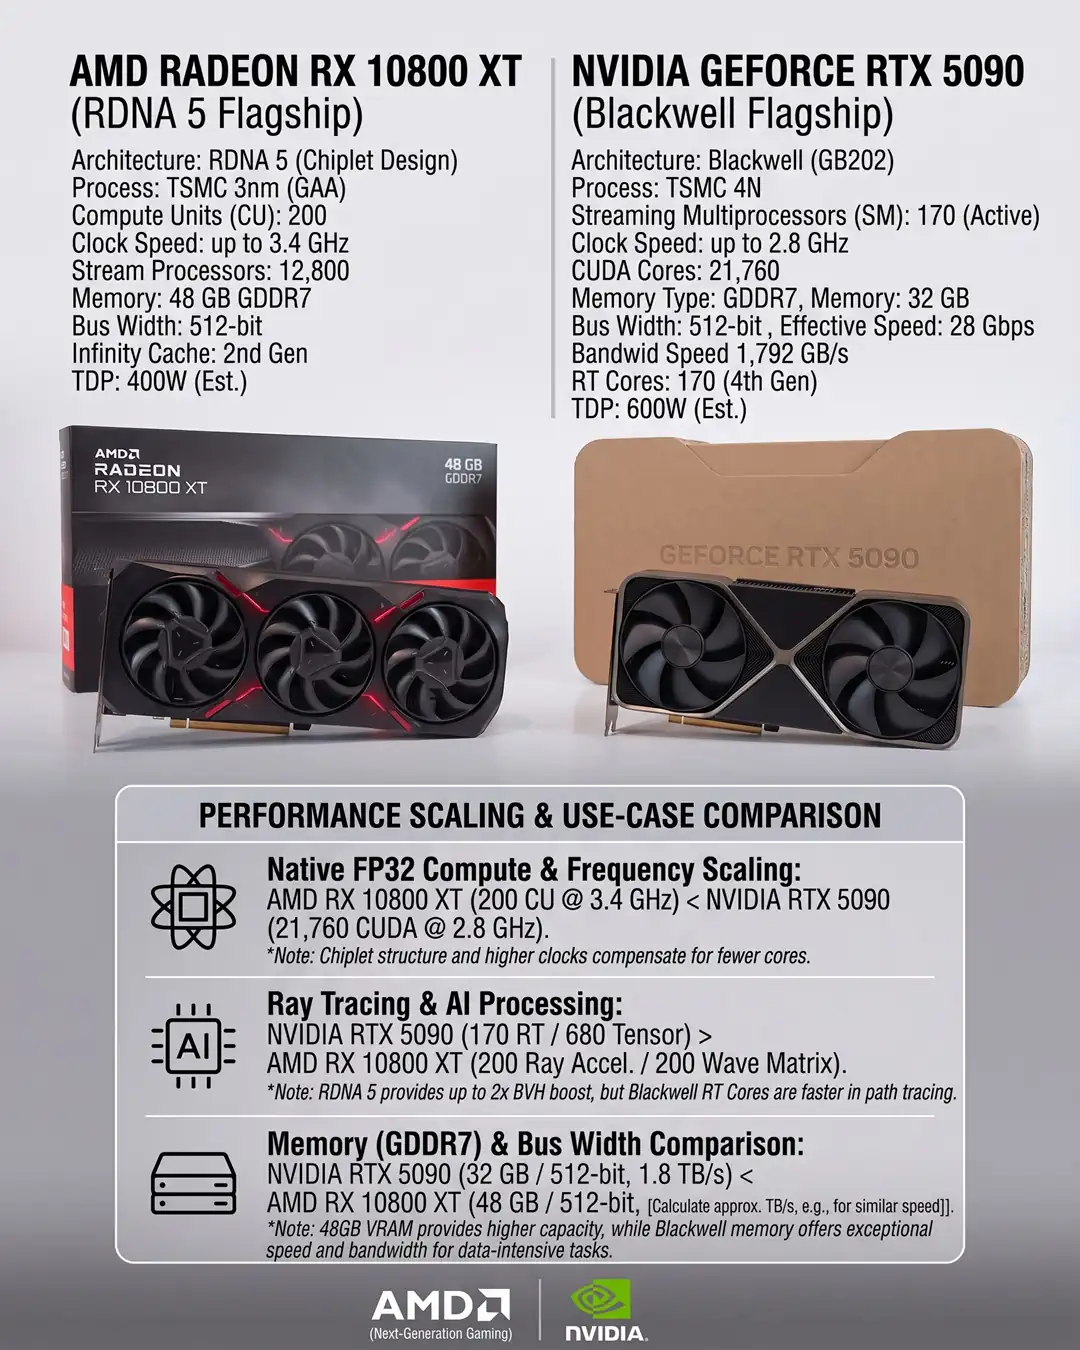
在光线追踪场景中,情况有所不同。 RDNA 5 架构中的光线加速处理以及每 CU 的 BVH 树处理速度加倍,使 RX 10800 XT 能够克服其在混合光线追踪游戏中的弱点,并实现与 RTX 5090 相当的帧速率。然而,RTX90 的全景跟踪仍然无法实现。 NVIDIA 的第五代 RT 专用核心将比 AMD 提供 35-50% 的优势。至于AI规模,200个CU内集成Wave Matrix单元可以基于神经网络生成完整的FSR帧,使图像质量更接近DLSS,尽管RTX 6090中的独立Tensor核心仍然保持较低的延迟。
在支持 CUDA 和 OptiX 的专业 3D 渲染软件中,NVIDIA 显卡在终极渲染速度方面保持领先地位。然而,在与 ROCm 或 HIP 配合使用时,巨大的 48 GB GDDR7 显存给了 RX 10800 XT 巨大的优势,使其能够将繁重的 8K 纹理和复杂的几何场景加载到本地内存,否则会因为 RTX 5090 的 32 GB 显存而下降。在虚幻引擎 5 中处理视频和工作时,512 位总线和双 VCN 媒体引擎可提供高质量 RAW 源的流畅编辑,无需创建代理,并加速 Nanite 几何体的编译。对于本地AI任务,48GB显存允许Llama 3 70B等大型语言模型直接在单个GPU上运行。在批量大小方面落后于 RTX 5090 的 GPU。
旗舰显卡 AMD Radeon RX 10800 XT 及其 170 SM 拥有大量 200 个 CU、高频率效率和 48 GB VRAM,在经典游戏、视频编辑和本地神经网络工作负载方面可靠地优于 NVIDIA GeForce RTX 5090。 AMD的新产品无法击败NVIDIA GeForce RTX 6090,因为其Ruby架构凭借192个专用SM的组合以及显着更高的性能的专用RT和Tensor核心,在最复杂的任务中保持了领先地位。路径跟踪和 CUDA 计算。最终,RX 10800 XT 将在光栅速度和内存容量方面与 RTX 5090 直接竞争,但 RTX 6090 在绝对图形处理能力方面占据榜首。